应用

VEED AI官网

VEED AI游戏生成器是一个多功能的AI工具,它通过文本到图像的转换技术,帮助游戏开发者快速获取游戏设计和营销的视觉素材。

VidFul.ai

一个利用Kling AI和Luma AI Dream Machine技术的AI视频生成器,将文本和图像快速转化为专业视频。用户只需通过VidFul.ai输入文本或上传图像,即可轻松生成不错的视频。

Magic3D

Magic3D是GPU制造商Nvidia在2023年2月宣布推出Magic3D,这是一种生成式AI技术,可以根据文本提示生成3D模型。

LongVU

LongVU是一款由Meta AI团队研发的长视频理解工具,其核心在于时空自适应压缩机制,可有效减少视频标记数量并保留关键视觉细节。该工具通过跨模态查询与帧间依赖性分析,实现了对冗余帧的剔除及帧特征的选择性降低,并基于时间依赖性进一步压缩空间标记。LongVU支持高效处理长视频,适用于视频内容分析、搜索索引、生成描述等多种应用场景。

S2V

S2V-01是MiniMax研发的视频生成模型,基于单图主体参考架构,可快速生成高质量视频。它能精准还原图像中的面部特征,保持角色一致性,并通过文本提示词灵活控制视频内容。支持720p、25fps高清输出,具备电影感镜头效果,适用于短视频、广告、游戏、教育等多种场景,具有高效、稳定和高自由度的特点。

Large Action Models

Large Action Models(LAMs)是微软开发的一种智能系统框架,专注于执行真实世界任务。它通过整合数据收集、模型训练、环境交互和评估等阶段,将语言理解转化为具体行动,提升了AI在自动化和增强人类能力方面的影响力。LAMs具备动态规划、自主执行和专业化训练等特点,广泛应用于办公自动化、智能家居管理、客户服务、电子商务等领域。 ---

AnimateDiff

AnimateDiff是一款由上海人工智能实验室、香港中文大学和斯坦福大学的研究人员共同开发的框架,旨在将文本到图像模型扩展为动画生成器。该框架利用大规模视频数据集中的运动先验知识,允许用户通过文本描述生成动画序列,无需进行特定的模型调优。AnimateDiff支持多种领域的个性化模型,包括动漫、2D卡通、3D动画和现实摄影等,并且易于与现有模型集成,降低使用门槛。
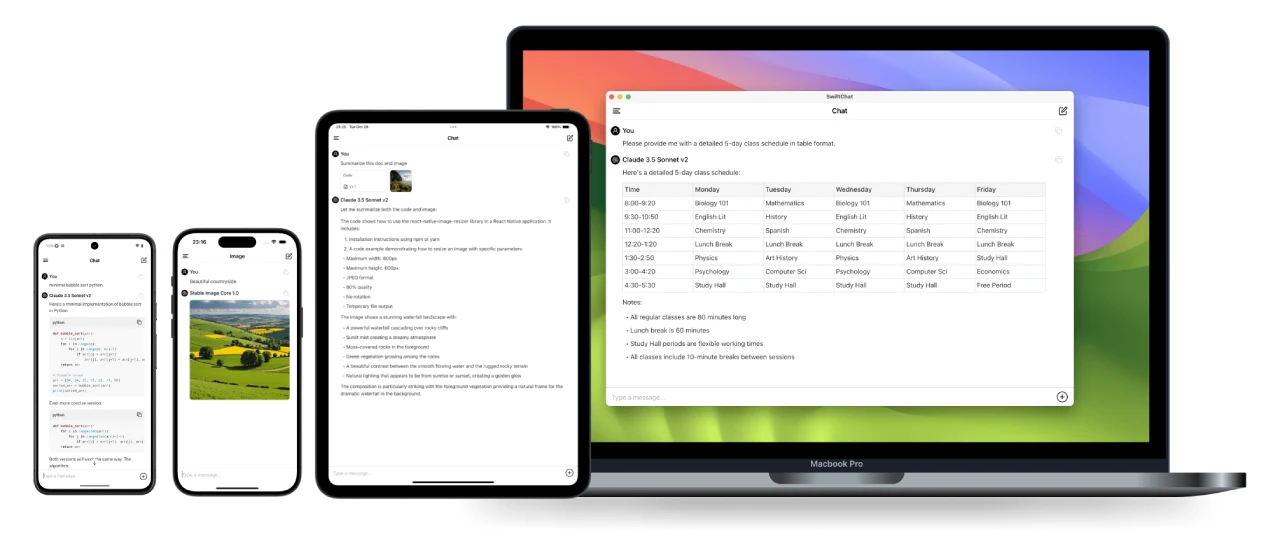
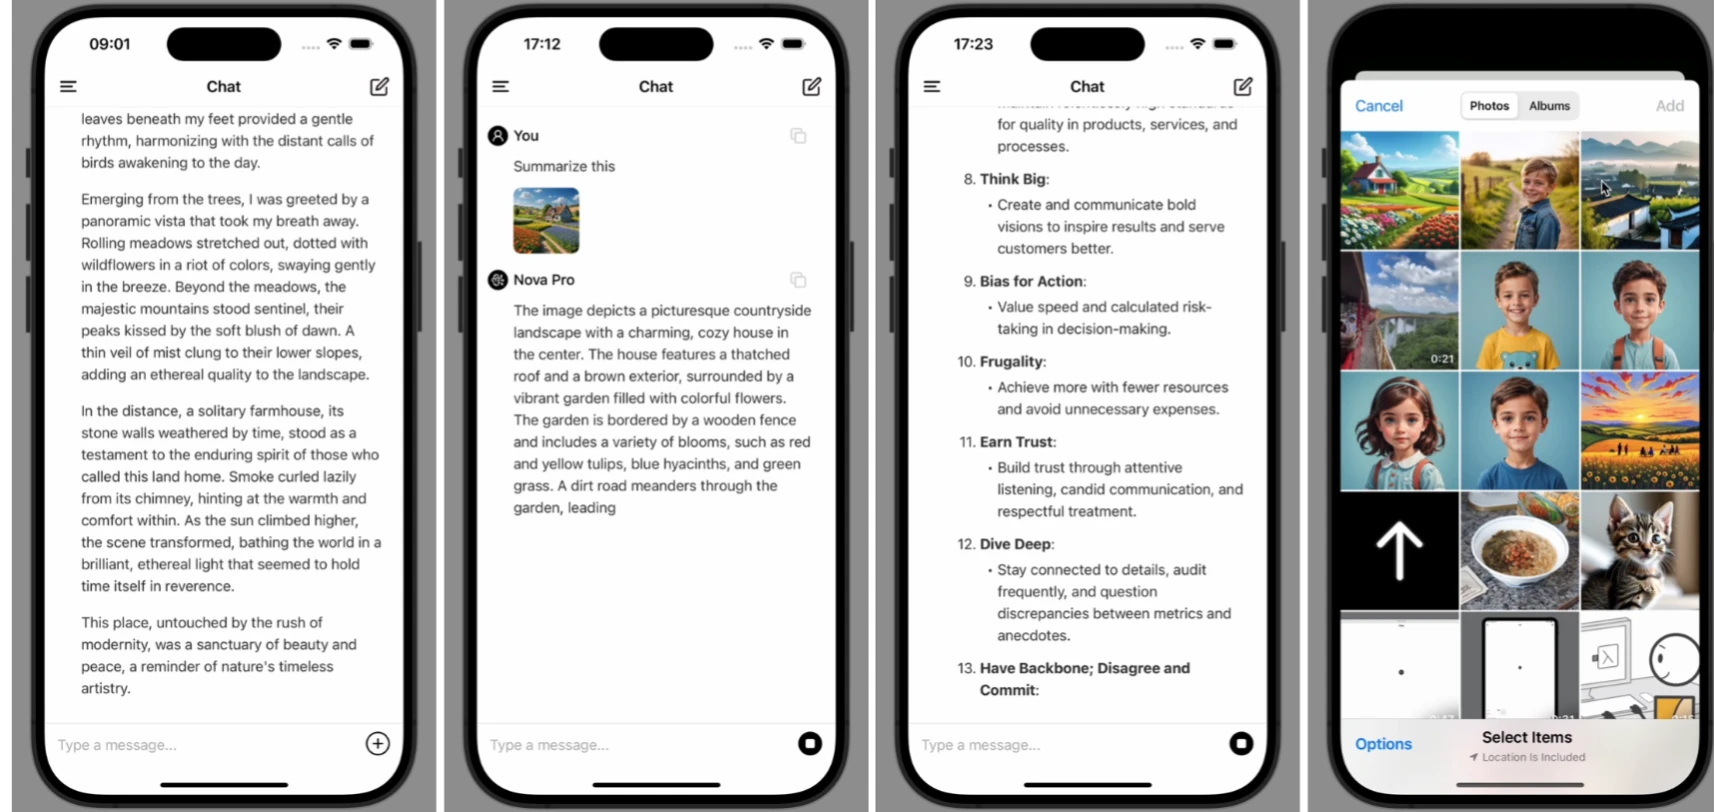
SwiftChat

一款基于React Native开发的快速、安全、跨平台聊天应用,支持实时流式聊天功能和Markdown语法,还可以生成AI图像,兼容DeepSeek、Amazon Bedrock、Ollama和OpenAI等模型。