多模态

S2V

S2V-01是MiniMax研发的视频生成模型,基于单图主体参考架构,可快速生成高质量视频。它能精准还原图像中的面部特征,保持角色一致性,并通过文本提示词灵活控制视频内容。支持720p、25fps高清输出,具备电影感镜头效果,适用于短视频、广告、游戏、教育等多种场景,具有高效、稳定和高自由度的特点。

Genesis

Genesis是一款基于开源架构的生成式物理引擎,具备高度准确的物理模拟能力,涵盖物体运动、流体力学、碰撞检测等领域。其显著特点包括超高速模拟、轻量级机器人仿真平台、照片级真实感渲染以及支持自然语言输入的数据生成功能。Genesis旨在推动通用机器人、具身AI及物理AI的发展,适用于机器人训练、游戏开发、影视特效制作等多个领域。

mPLUG

mPLUG-Owl3是一款由阿里巴巴开发的多模态AI模型,专注于理解和处理多图及长视频内容。该模型具备高推理效率和准确性,采用创新的Hyper Attention模块优化视觉与语言信息的融合。它已在多个基准测试中展现出卓越性能,并且其源代码和资源已公开,可供研究和应用。

Liquid

Liquid是由华中科技大学、字节跳动和香港大学联合开发的多模态生成框架,通过VQGAN将图像编码为离散视觉token并与文本共享词汇空间,使大型语言模型无需修改结构即可处理视觉任务。该框架降低训练成本,提升视觉生成与理解性能,并在多模态任务中表现出色。支持图像生成、视觉问答、多模态融合等应用,适用于创意设计、内容创作及智能交互等领域。

VersaGen

VersaGen是一款基于生成式AI的文本到图像合成工具,支持多样化视觉控制和灵活的创意表达。通过适配器训练和优化策略,VersaGen将视觉信息融入生成过程中,显著提升了图像质量和用户体验。该工具适用于创意设计、数字艺术、广告营销、游戏开发及影视制作等多个领域,为用户提供了高效且直观的视觉创作解决方案。

Mistral OCR

Mistral OCR 是 Mistral AI 推出的高效 OCR 工具,支持多语言、多格式文档处理,准确率高达 99.02%。具备结构化输出、高速处理、多模态识别及 Doc-as-prompt 功能,适用于科研、文化遗产保护及企业文档管理等场景。
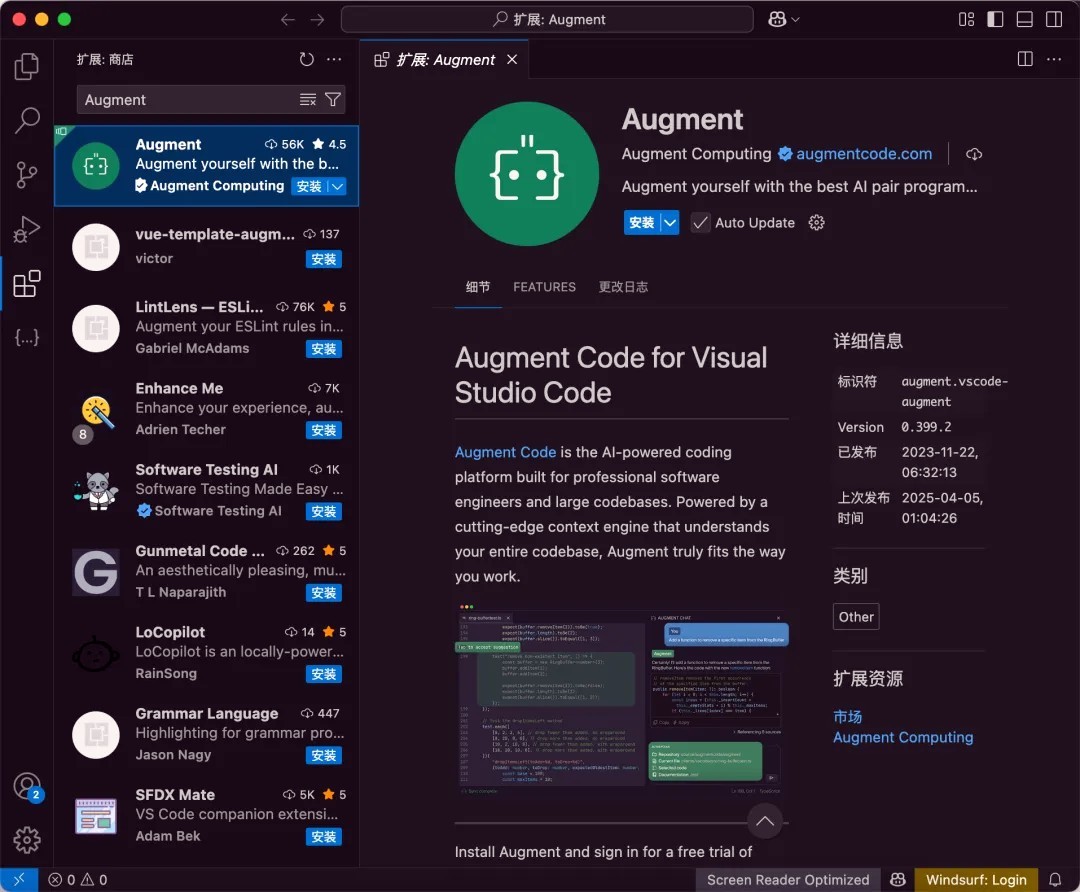
Augment Code

一家专注于为大型代码库提供AI编程辅助工具的公司,通过上下文感知开发、个性化代码补全、跨文件编辑等功能,帮助开发团队提升效率,特别是擅长处理复杂代码库的维护和重构。

Transfusion

Transfusion是由Meta公司开发的多模态AI模型,能够同时生成文本和图像,并支持图像编辑功能。该模型通过结合语言模型的下一个token预测和扩散模型,在单一变换器架构上处理混合模态数据。Transfusion在预训练阶段利用了大量的文本和图像数据,表现出强大的扩展性和优异的性能。其主要功能包括多模态生成、混合模态序列训练、高效的注意力机制、模态特定编码、图像压缩、高质量图像生成、文本生成
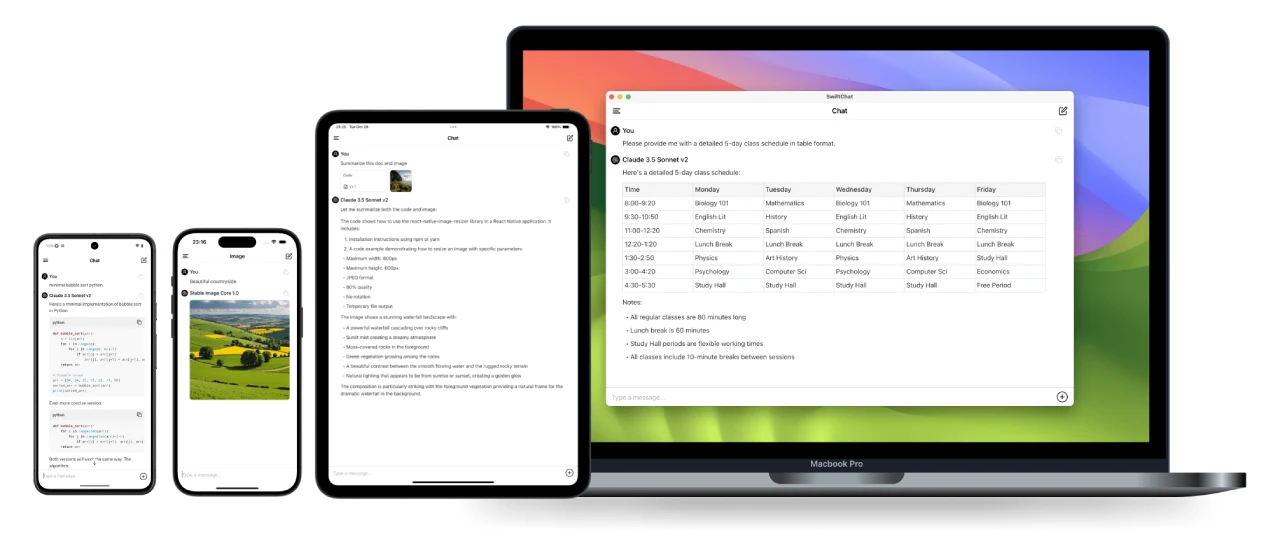
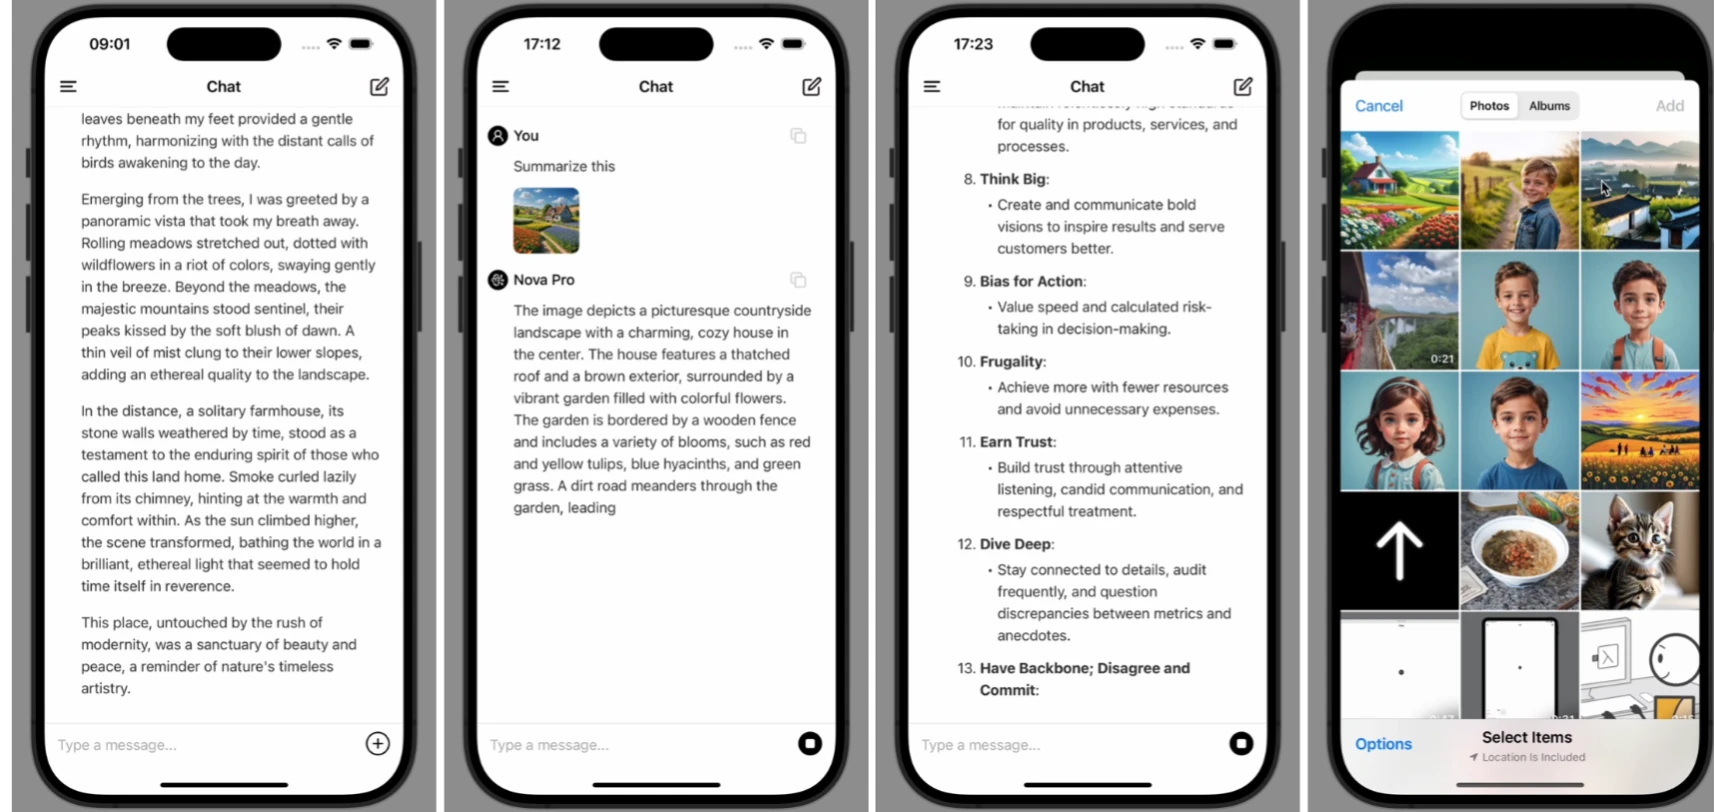
SwiftChat

一款基于React Native开发的快速、安全、跨平台聊天应用,支持实时流式聊天功能和Markdown语法,还可以生成AI图像,兼容DeepSeek、Amazon Bedrock、Ollama和OpenAI等模型。

视界一粟YiSu

北京极佳视界科技有限公司联合清华大学自动化系共同发布的Sora级视频生成大模型。
