音频

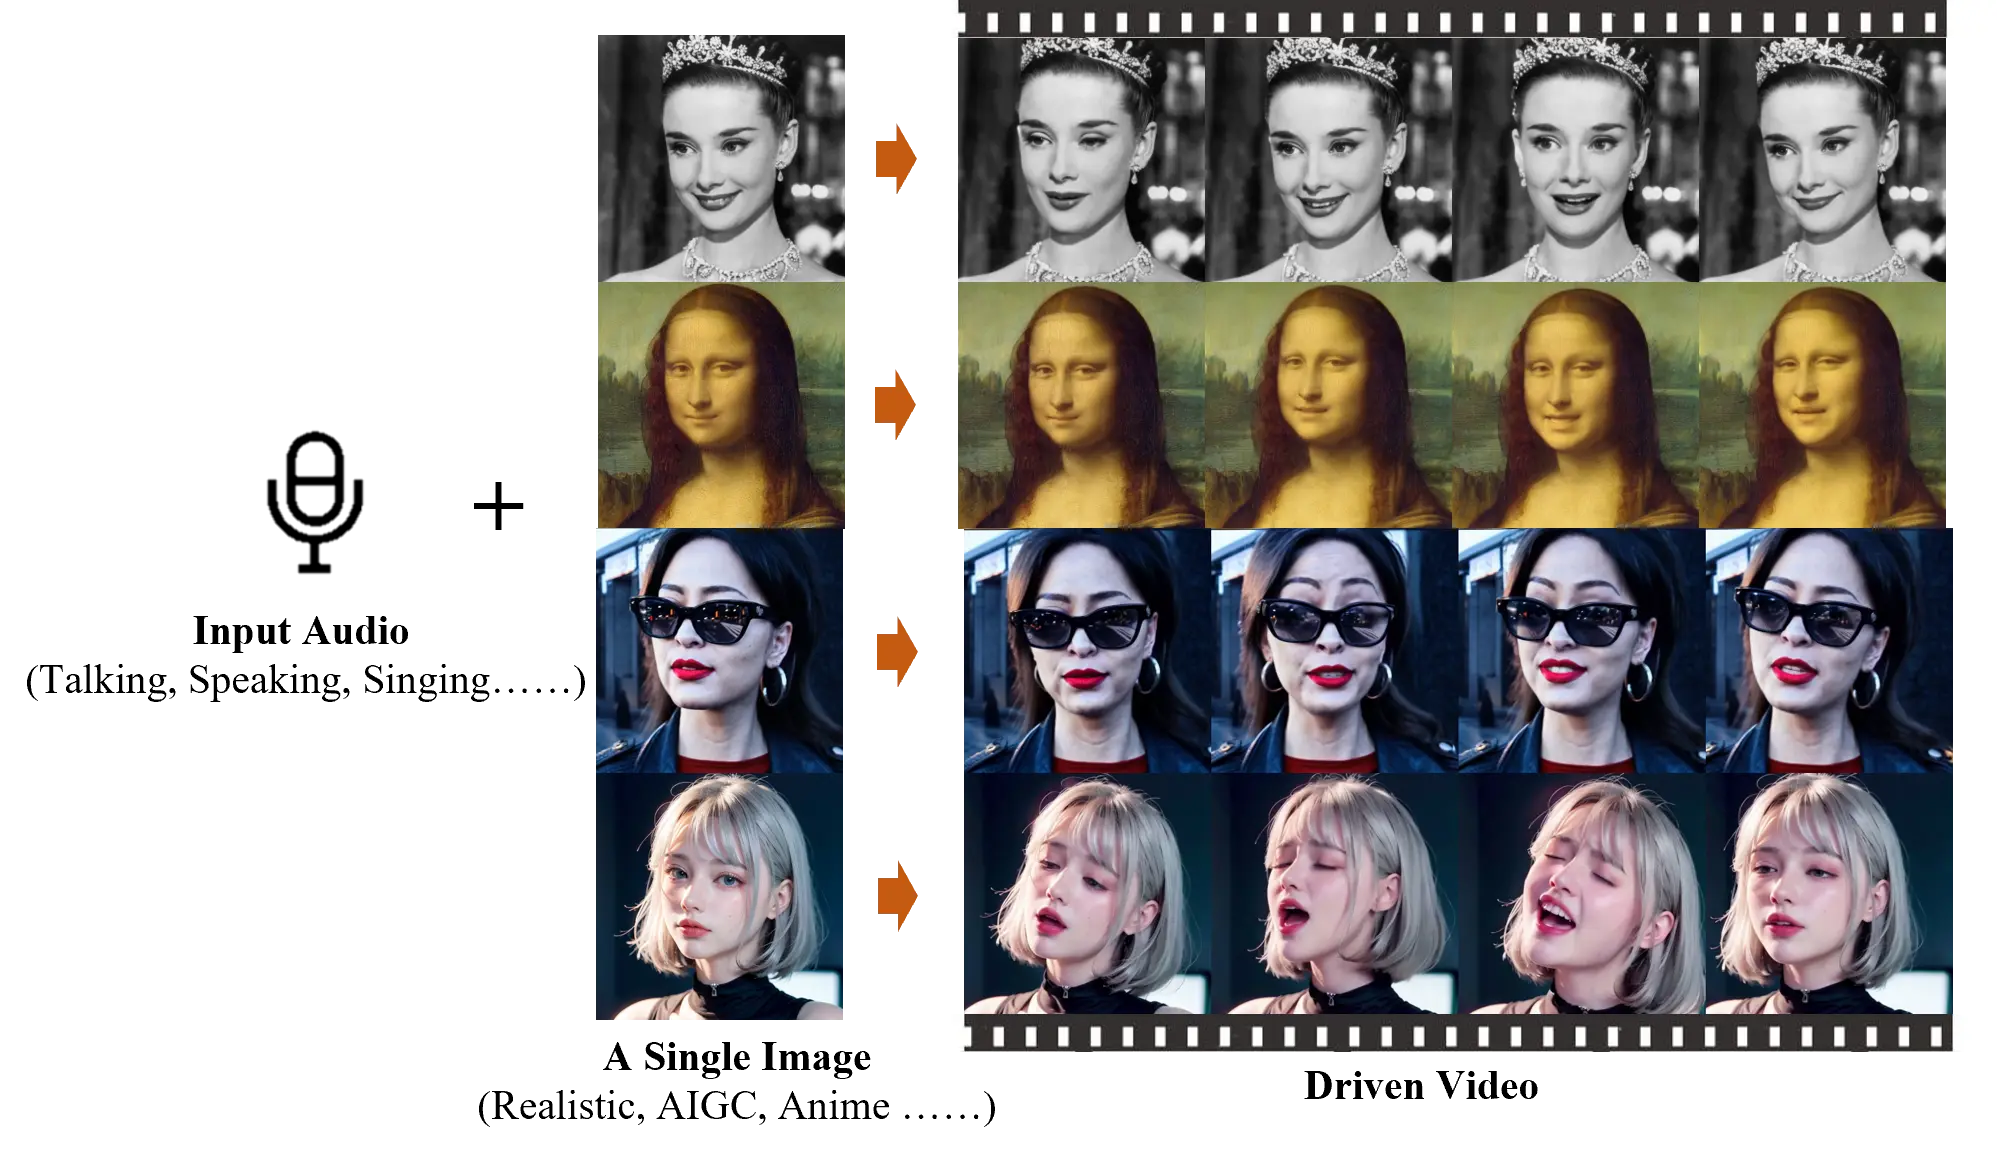
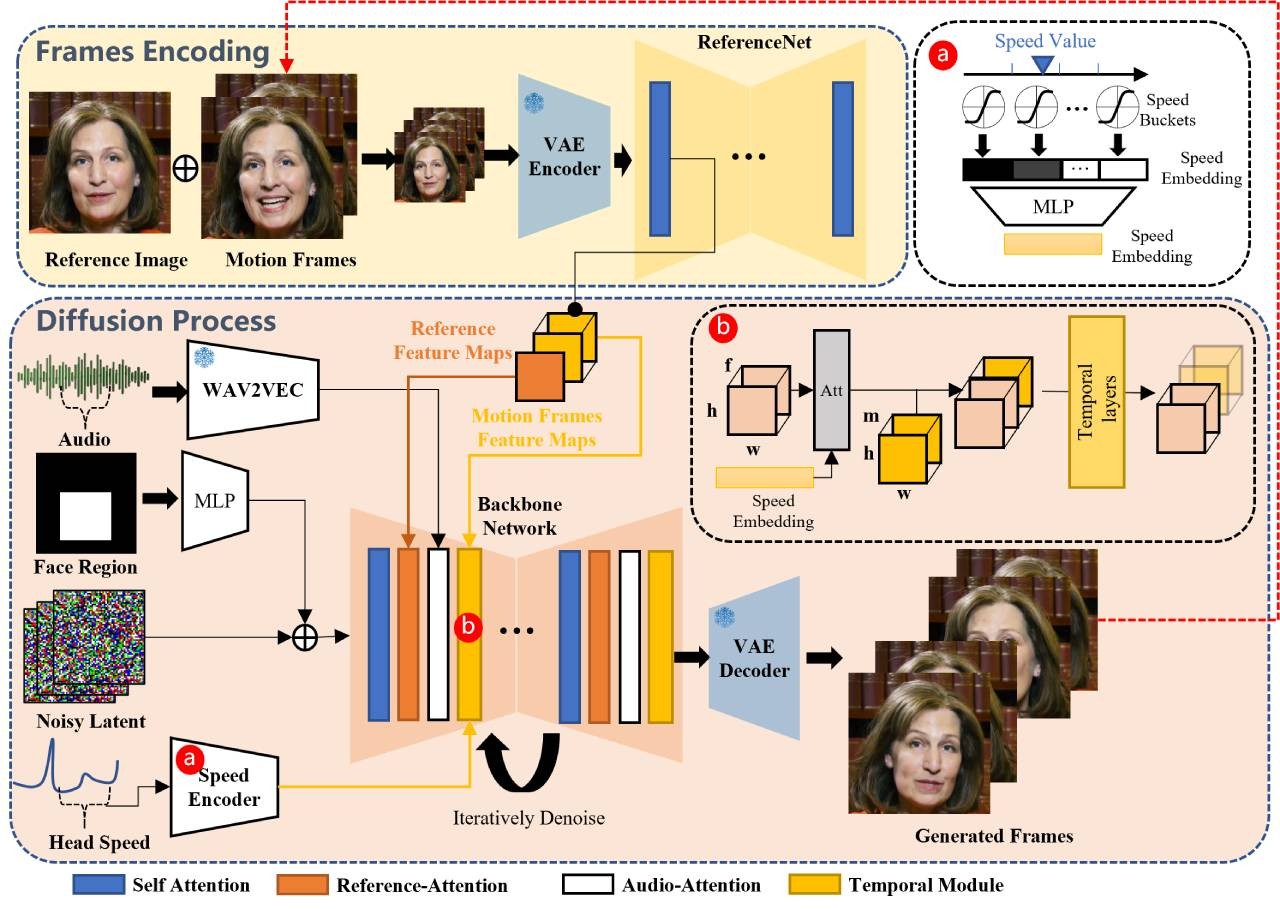
Emote Portrait Alive

阿里巴巴发布的EMO,一种音频驱动的AI肖像视频生成框架。通过输入单一的参考图像和语音音频,Emote Portrait Alive可以生成动态的、表情丰富的肖像视频。

ChatTTS

ChatTTS是一个开源的专为对话场景设计的语音生成模型,特别适用于大语言模型(LLM)助手的对话任务,以及诸如对话式音频和视频介绍等应用。ChatTTS 不仅能说中文,英文也能 hold 住...

Noisli

Noisli.com 是一个提供背景噪音和环境声音的平台,旨在帮助用户在工作中保持专注、睡眠和放松。

音虫

音虫SoundBug是一款由国内团队研发的数字音频工作站(DAW)软件,以其简洁直观的用户界面和易于上手的操作特点,为音乐爱好者和音乐学习者提供了一套完整的音乐制作工具。

CoGenAV

CoGenAV是一种先进的多模态学习模型,专注于音频和视觉信号的对齐与融合。通过对比特征对齐和生成文本预测的双重目标进行训练,利用同步音频、视频和文本数据,学习捕捉时间对应关系和语义信息。CoGenAV具备音频视觉语音识别、视觉语音识别、噪声环境下的语音处理、语音重建与增强、主动说话人检测等功能,适用于智能助手、视频内容分析、工业应用和医疗健康等多个场景。

TTS

TTS语音向导是一种工具,允许用户通过微软Azure语音识别和TTS将语音转换为文本,然后再转换回语音。它还向VRChat发送OSC消息以在头像上显示文本。该工具有许多自定义选项,包括100...

EchoMimicV2

EchoMimicV2是一款由阿里巴巴蚂蚁集团研发的AI数字人动画生成工具,能够基于参考图片、音频剪辑及手部姿势序列生成高质量的半身动画视频。它支持多语言(中英双语)输入,并通过音频-姿势动态协调、头部局部注意力及特定阶段去噪损失等技术手段显著提高了动画的真实度与细节表现力,适用于虚拟主播、在线教育、娱乐游戏等多个领域。

WorldSense

WorldSense是由小红书与上海交通大学联合开发的多模态基准测试工具,用于评估大型语言模型在现实场景中对视频、音频和文本的综合理解能力。该平台包含1662个同步视频、3172个问答对,覆盖8大领域及26类认知任务,强调音频与视频信息的紧密耦合。所有数据经专家标注并多重验证,确保准确性。适用于自动驾驶、智能教育、监控、客服及内容创作等多个领域,推动AI模型在多模态场景下的性能提升。

MagicMic

MagicMic是一个功能强大的声音变换工具,适用于游戏玩家、主播和内容创作者。它通过提供丰富的声音过滤器和音效,以及实时声音变换技术,使用户能够在游戏中或在线聊天中保护隐私...

逗哥配音神器

逗哥配音神器是一个功能全面的在线配音平台,提供了从文案输入到配音生成、下载及字幕制作的一站式服务。
