音频

EchoMimic

EchoMimic是一款由阿里蚂蚁集团开发的AI数字人开源项目,通过深度学习模型结合音频和面部标志点,创造出高度逼真的动态肖像视频。该工具支持音频同步动画、面部特征融合、多模态学习和跨语言能力,适用于娱乐、教育和虚拟现实等领域。其独特的技术原理包括音频特征提取、面部标志点定位、面部动画生成和多模态学习,使用了卷积神经网络(CNN)、循环神经网络(RNN)和生成对抗网络(GAN)等深度学习模型,实现

Decoherence.Co

Decoherence是一款文本生成AI视频的工具,用户能从各种AI风格中进行选择。

Kokoro

Kokoro-TTS是一款由hexgrad开发的轻量级文本转语音工具,基于StyleTTS 2与ISTFTNet架构,支持多种语音风格和自然语调,具备实时处理能力。支持美式与英式英语,提供10种语音包,适用于教育、游戏、客服等多种场景。支持本地部署与API集成,确保数据安全与高效运行。

Hallo

Hallo是由复旦大学、百度公司、苏黎世联邦理工学院和南京大学的研究团队共同开发的一种基于人工智能的肖像图像动画技术。该技术通过分层音频驱动视觉合成、端到端扩散模型、交叉注意力机制、UNet去噪器、时间对齐技术和参考网络等方法,实现了音频与视觉输出的高精度同步。Hallo具备音频同步动画、面部表情生成、头部姿态控制、个性化动画定制、时间一致性维护以及动作多样性等主要功能,显著提升了视频动画的真实感

JoyVASA

JoyVASA是一个基于扩散模型的音频驱动数字人头项目,能够生成与音频同步的面部动态和头部运动。其主要功能包括唇形同步、表情控制及动物面部动画生成,支持多语言和跨物种动画化。项目采用两阶段训练方法,结合解耦面部表示与扩散模型技术,生成高质量动画视频,广泛应用于虚拟助手、娱乐媒体、教育、广告等多个领域。

UniScribe

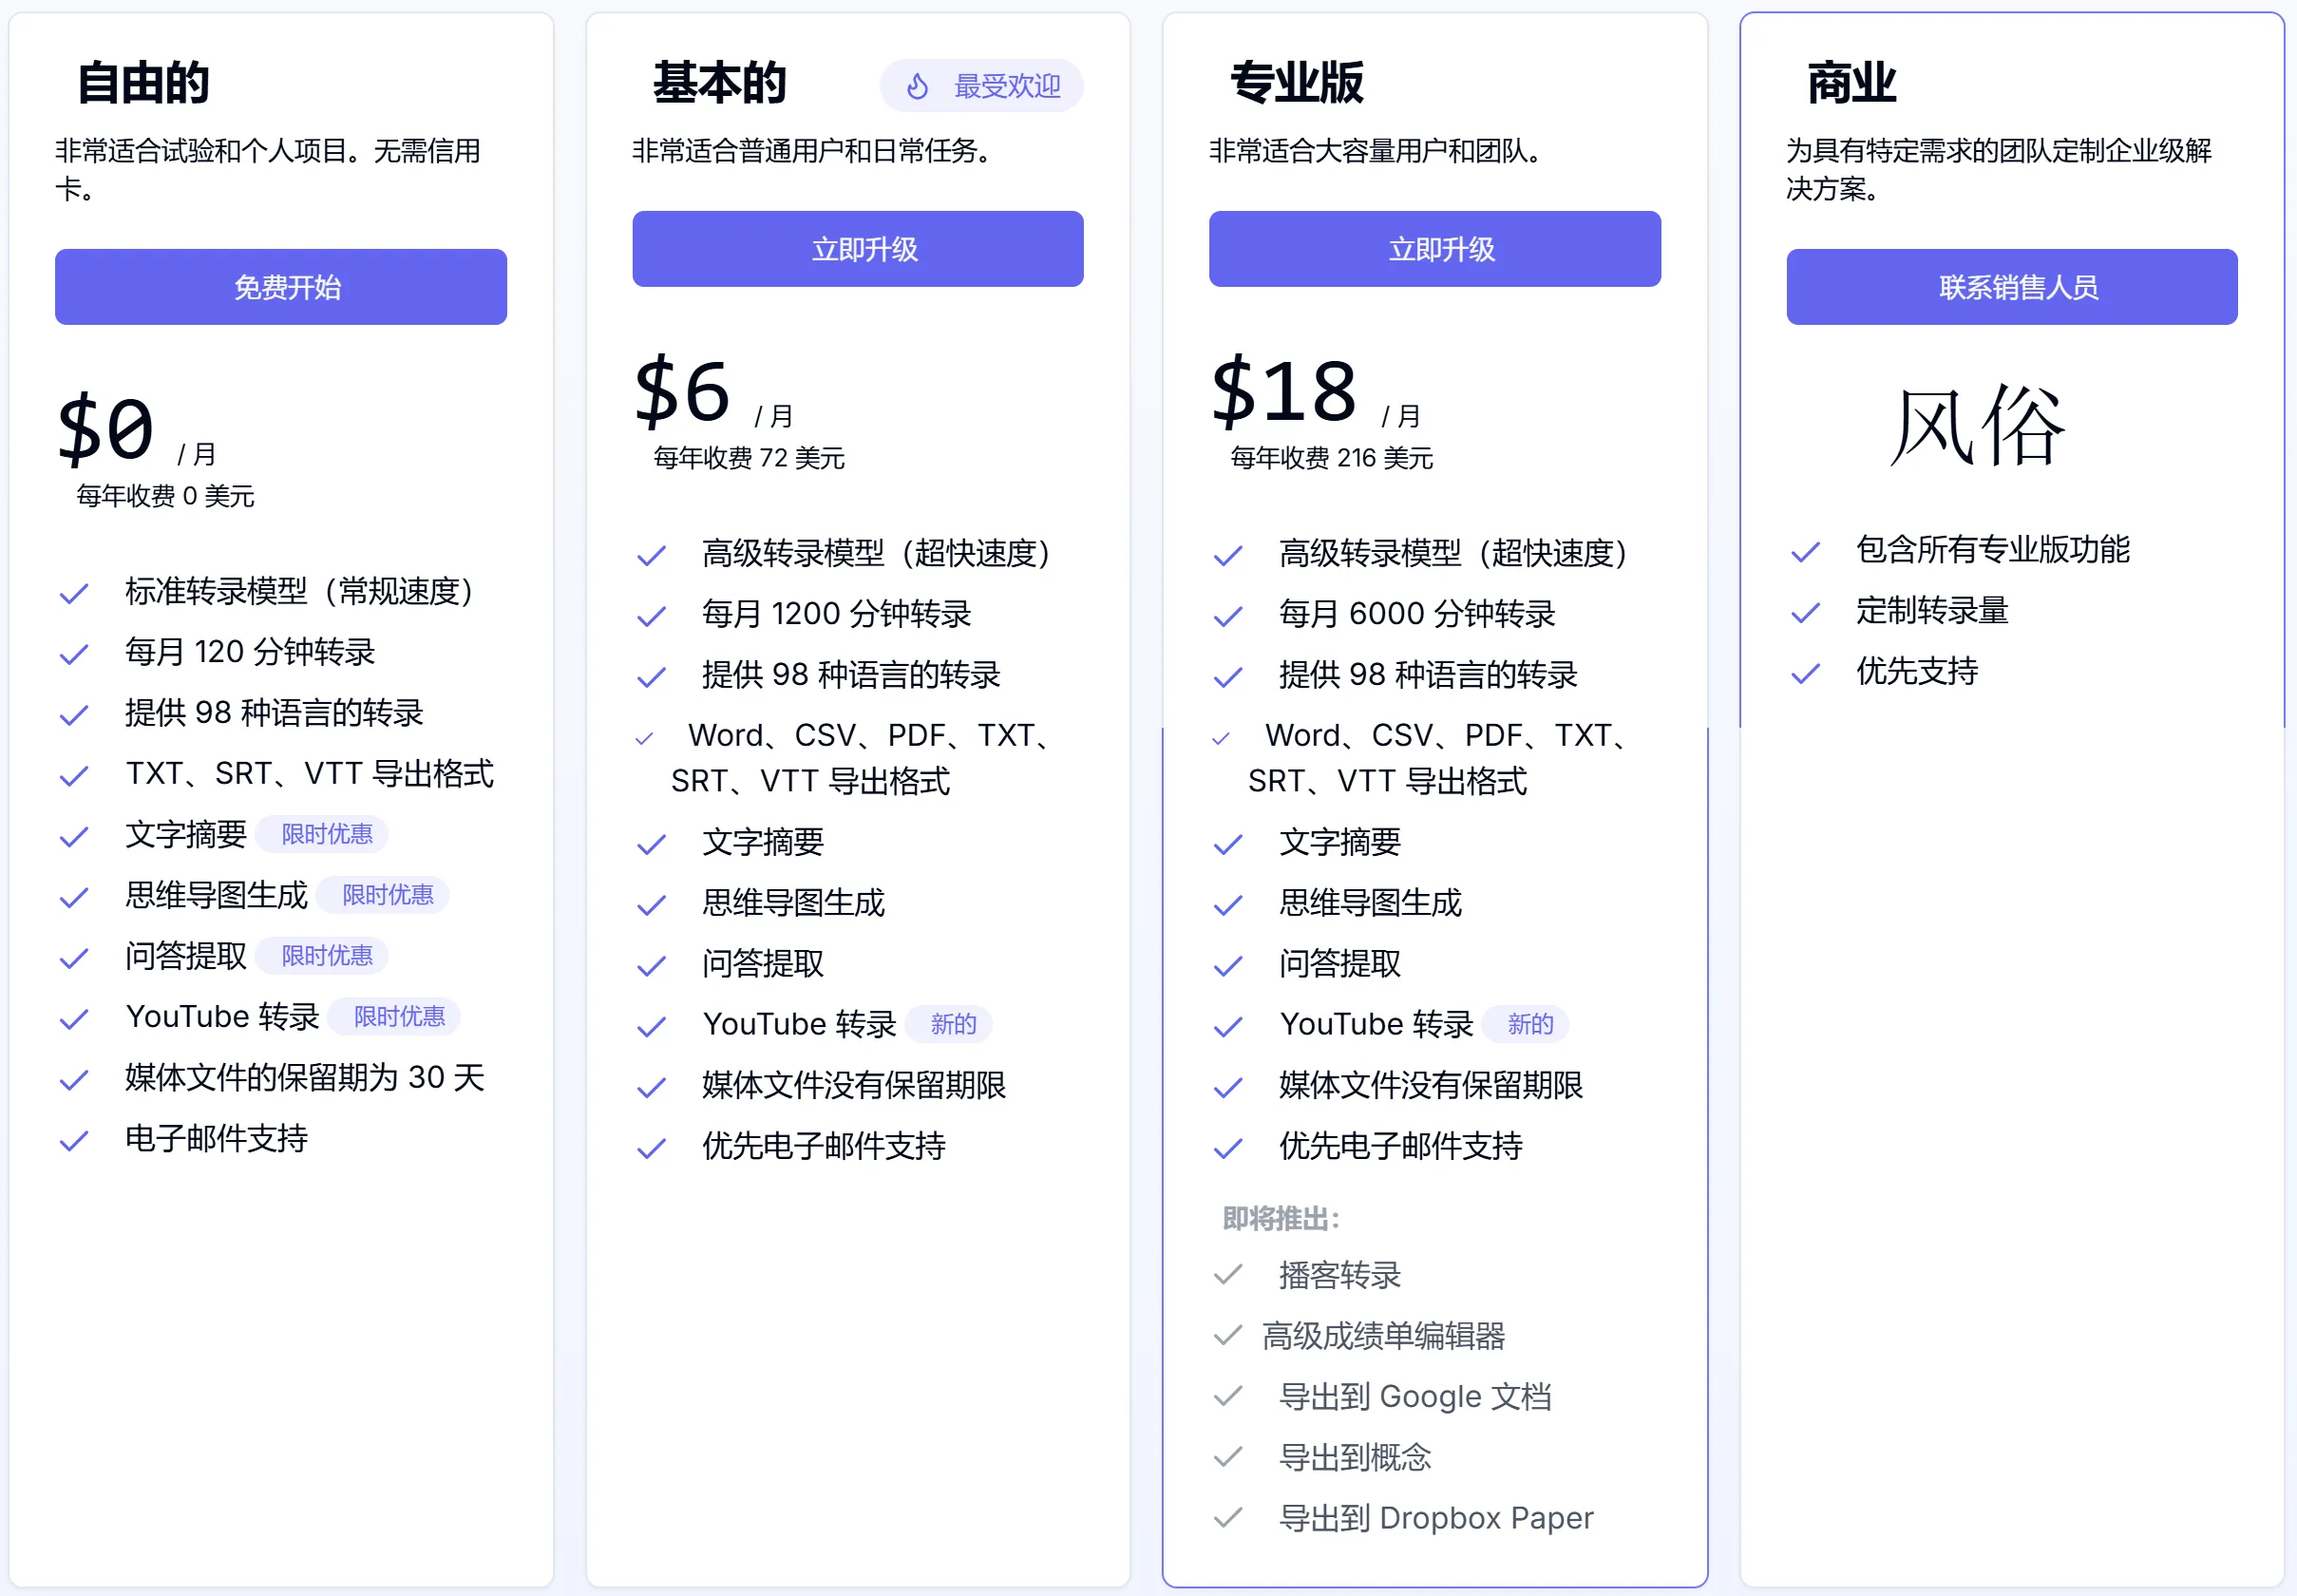
一个帮你更快的从音视频中获取信息的音视频转录和翻译工具。UniScribe能快速将本地音频、视频文件或 YouTube 视频转化为简短摘要,帮助您轻松掌握要点,支持98种语言。

LipRead Pro

LipRead Pro 是一款基于AI技术的视频唇读工具,可将视频中的唇部动作转换为文字,支持多语言和口音识别。其高精度算法确保了文字输出的准确性,适用于内容创作、无障碍辅助、安全监控、历史档案修复等多种场景。操作简便,处理高效,注重用户数据隐私保护,适合专业用户和普通用户使用。

Podcastle

Podcastle是一款以AI为核心的播客制作平台,集成了录音室、音频与视频编辑器及AI生成的声音工具,支持本地多人协作录音、降噪处理、品牌定制化功能及声音克隆技术。该平台覆盖从创意到发布的全链条服务,并支持内容托管与多平台分发,适用于个人播客、远程采访、教育培训、企业沟通及有声读物制作等多种场景。

AniPortrait

AniPortrait是一款由腾讯开源的AI视频生成框架,通过音频和一张参考肖像图片生成高质量的动画。该框架包含两个核心模块:Audio2Lmk模块将音频转换为2D面部标记点,而Lmk2Video模块则基于这些标记点生成连贯且逼真的视频动画。AniPortrait以其高质量的视觉效果、时间一致性和灵活的编辑能力著称,能够精确捕捉面部表情和嘴唇动作。


TIGER

TIGER是由清华大学研发的轻量级语音分离模型,采用时频交叉建模策略与多尺度注意力机制,有效提升语音分离性能,同时显著降低计算和参数开销。模型通过频带切分优化资源利用,适应复杂声学环境,广泛应用于会议记录、视频剪辑、电影音频处理及智能语音助手等领域。