DreamActor DreamActor-M1是字节跳动推出的AI图像动画框架,能够将静态照片转化为高质量动态视频。其核心在于混合引导机制,结合隐式面部表示、3D头球和身体骨架,实现对表情和动作的精准控制。支持多语言语音驱动、口型同步、灵活运动转移及多样化风格适配,适用于虚拟角色创作、个性化动画生成、虚拟主播制作及创意广告等领域,具备高保真、强连贯性和广泛适用性。 AI项目与工具 2025年06月12日 86 点赞 0 评论 955 浏览
Multi Multi-Speaker 是 AudioShake 推出的高分辨率多说话人分离工具,支持将音频中不同说话人的语音精准分离至独立轨道,适用于广播级音频处理。它具备高保真音频处理能力,支持高采样率,能处理长达数小时的录音,在复杂场景下仍能保持稳定效果。广泛应用于影视、播客、无障碍服务及内容创作等领域,提升音频编辑效率与质量。 AI项目与工具 2025年06月12日 55 点赞 0 评论 954 浏览
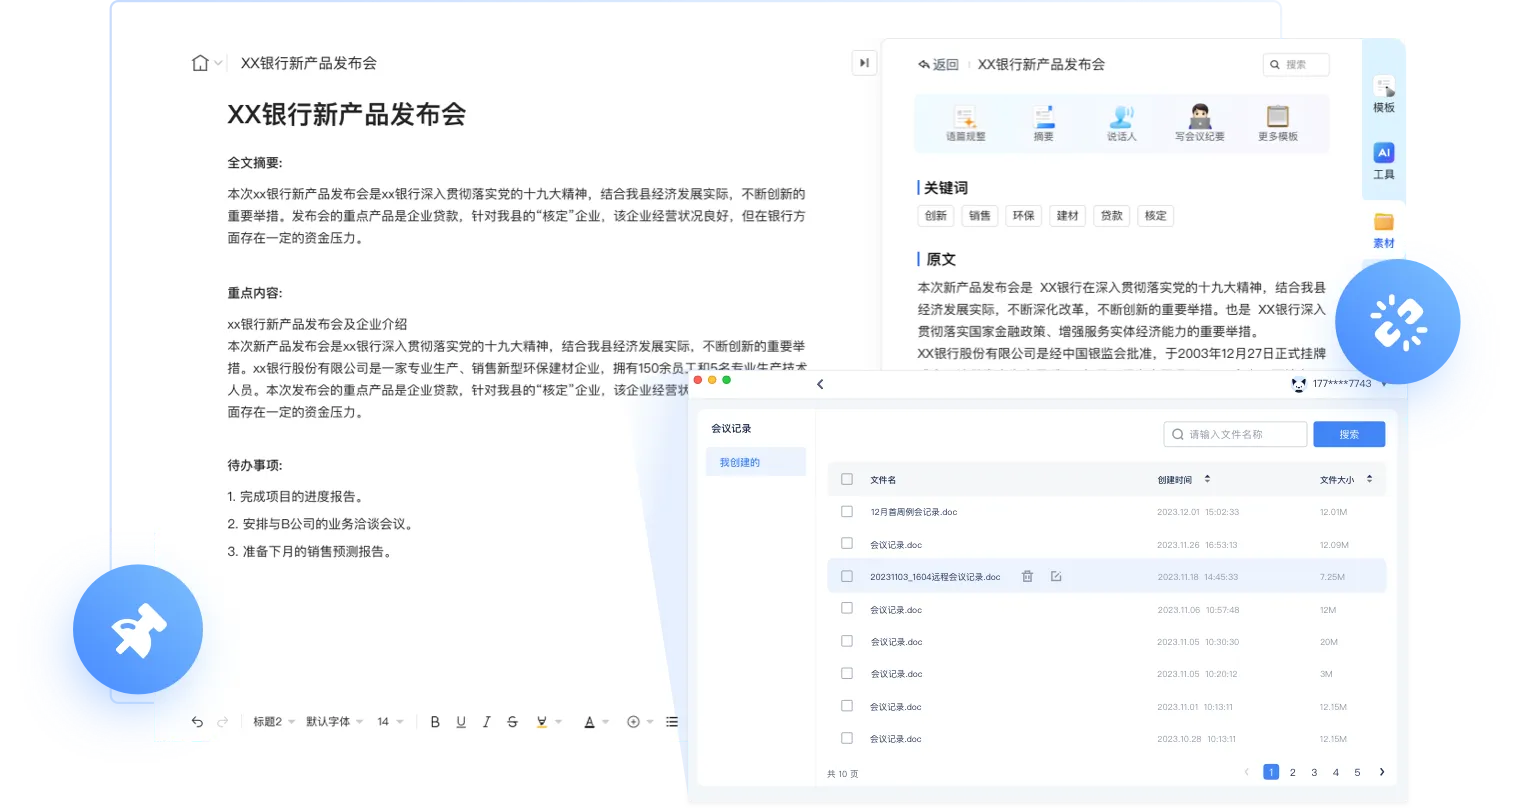
讯飞会议 科大讯飞推出的一款智能、高效、安全的云视频会议协作平台,为用户提供音视频清晰稳定流畅的音视频、多端协同、远程会议、AI降噪、实时多语种字幕、自动生成会议记录等功能。 Ai办公效率 2025年06月05日 40 点赞 0 评论 952 浏览
LatentLM LatentLM是一款由微软与清华大学合作开发的多模态生成模型,能够统一处理文本、图像、音频等多种数据类型。它基于变分自编码器(VAE)和因果Transformer架构,支持自回归生成与跨模态信息共享,特别擅长图像生成、多模态语言模型及文本到语音合成等任务,其提出的σ-VAE进一步提升了模型的鲁棒性。 AI项目与工具 2025年06月12日 67 点赞 0 评论 952 浏览
MaskGCT MaskGCT是一款基于掩码生成模型与语音表征解耦编码技术的语音合成大模型,由趣丸科技与香港中文大学(深圳)联合开发。其主要功能包括声音克隆、跨语种语音合成、语音控制及高质量语音数据集支持。该模型在多个TTS基准数据集上表现优异,可快速精准地克隆音色并灵活调整语音属性,适用于多种语言,已开源并面向全球用户开放。 AI项目与工具 2025年06月12日 35 点赞 0 评论 951 浏览
AI Chinese AI Chinese是一款利用AI技术打造的双语中文学习平台,提供个性化的在线教学服务。其核心功能包括AI模拟教学、双语教学支持、互动练习、语音识别与校正及提问解答等模块,能够满足个人自学、语言学校辅助教学、企业培训等多种应用场景需求。凭借自研中文知识图谱和精准语音反馈,该平台致力于帮助不同语言背景的学习者高效掌握中文。 AI项目与工具 2025年06月12日 98 点赞 0 评论 950 浏览
Universal Universal-1是一款由AssemblyAI开发的多语言语音识别和转录模型,经过大量多语种音频数据训练,支持英语、西班牙语、法语和德语等。该模型在各种复杂环境中提供高精度的语音转文字服务,具备快速响应能力和改进的时间戳准确性。Universal-1在准确率、响应时间、时间戳估计和用户偏好等方面表现优异,适用于对话智能平台、AI记事本、创作者工具和远程医疗平台等多个应用场景。 AI项目与工具 2024年01月01日 88 点赞 0 评论 950 浏览