开源

WriteHERE

WriteHERE是一款基于异质递归规划技术的开源AI写作框架,支持生成超长文本并动态分解写作任务为检索、推理和写作三种异构模块。通过有向无环图管理任务依赖关系,实现自适应执行,适用于小说创作、技术报告、行业分析等多场景。其数学形式化设计与任务可视化功能提升了写作过程的可控性和一致性,具备良好的扩展性与灵活性。

DeepFloyd

DeepFloyd IF是一个强大的文本到图像生成模型,能够生成高分辨率和逼真度的图像。它结合了先进的语言理解和图像生成技术,提供了多种功能,如超分辨率、风格迁移和零样本学习。

Reka Flash 3

Reka Flash 3 是一款由 Reka AI 开发的开源推理模型,拥有 21 亿参数,支持多模态输入(文本、图像、视频、音频),并可处理最长 32k 个令牌的上下文。它具备高效的推理能力和多语言支持,适用于日常对话、编码辅助、指令执行等多种场景。模型可在本地部署,支持 4 位量化以降低资源占用,适合广泛的应用需求。

Wren AI

Wren AI 是一个开源的文本到 SQL 工具,基于自然语言处理技术,允许用户通过自然语言提问来执行数据库查询,无需编写 SQL 代码。它支持多种数据库和数据源,具有语义理解能力,能准确解析业务上下文并提供精确的结果。Wren AI 的核心功能包括语义引擎、向量数据库和大型语言模型,支持数据集成、安全性和结果导出,广泛应用于业务智能分析、数据探索、报告生成等领域。

3D

3D-Speaker是一个多模态开源项目,专注于通过结合声学、语义和视觉信息,实现高精度的说话人识别和语种识别。其主要功能包括说话人日志、说话人识别、语种识别、多模态识别以及重叠说话人检测。项目提供了工业级模型、训练与推理代码,以及多样化数据集,并支持复杂环境下的语音处理任务。应用场景涵盖会议记录、法庭记录、广播制作、电话客服和安全监控等领域。

Hertz

Hertz-Dev是一款由Standard Intelligence开发的开源音频模型,专注于低延迟实时对话AI。它具备强大的音频生成与处理能力,能够处理和生成高质量的音频信号,并支持多任务微调,适用于语音识别、语音合成等多种应用场景。此外,Hertz-Dev还提供了音频自动编码、流式生成等功能,广泛应用于智能助手、客户服务、语音识别及合成等领域。

InvokeAI

InvokeAI 是一个开源项目,是 Stable Diffusion 模型的领先创意引擎,它为使用 Stable Diffusion 模型生成高质量图像提供了简化的过程。

Granite 4.0 Tiny Preview

Granite 4.0 Tiny Preview是IBM推出的轻量级语言模型,具备高效计算能力和紧凑结构,支持在消费级GPU上运行多个长上下文任务。采用混合Mamba-2/Transformer架构,结合高效与精准优势,支持无位置编码(NoPE)处理128K tokens上下文。内存需求降低72%,推理时仅激活1B参数,适用于边缘设备部署、长文本分析及企业级应用开发,适合资源受限环境下的AI研究与
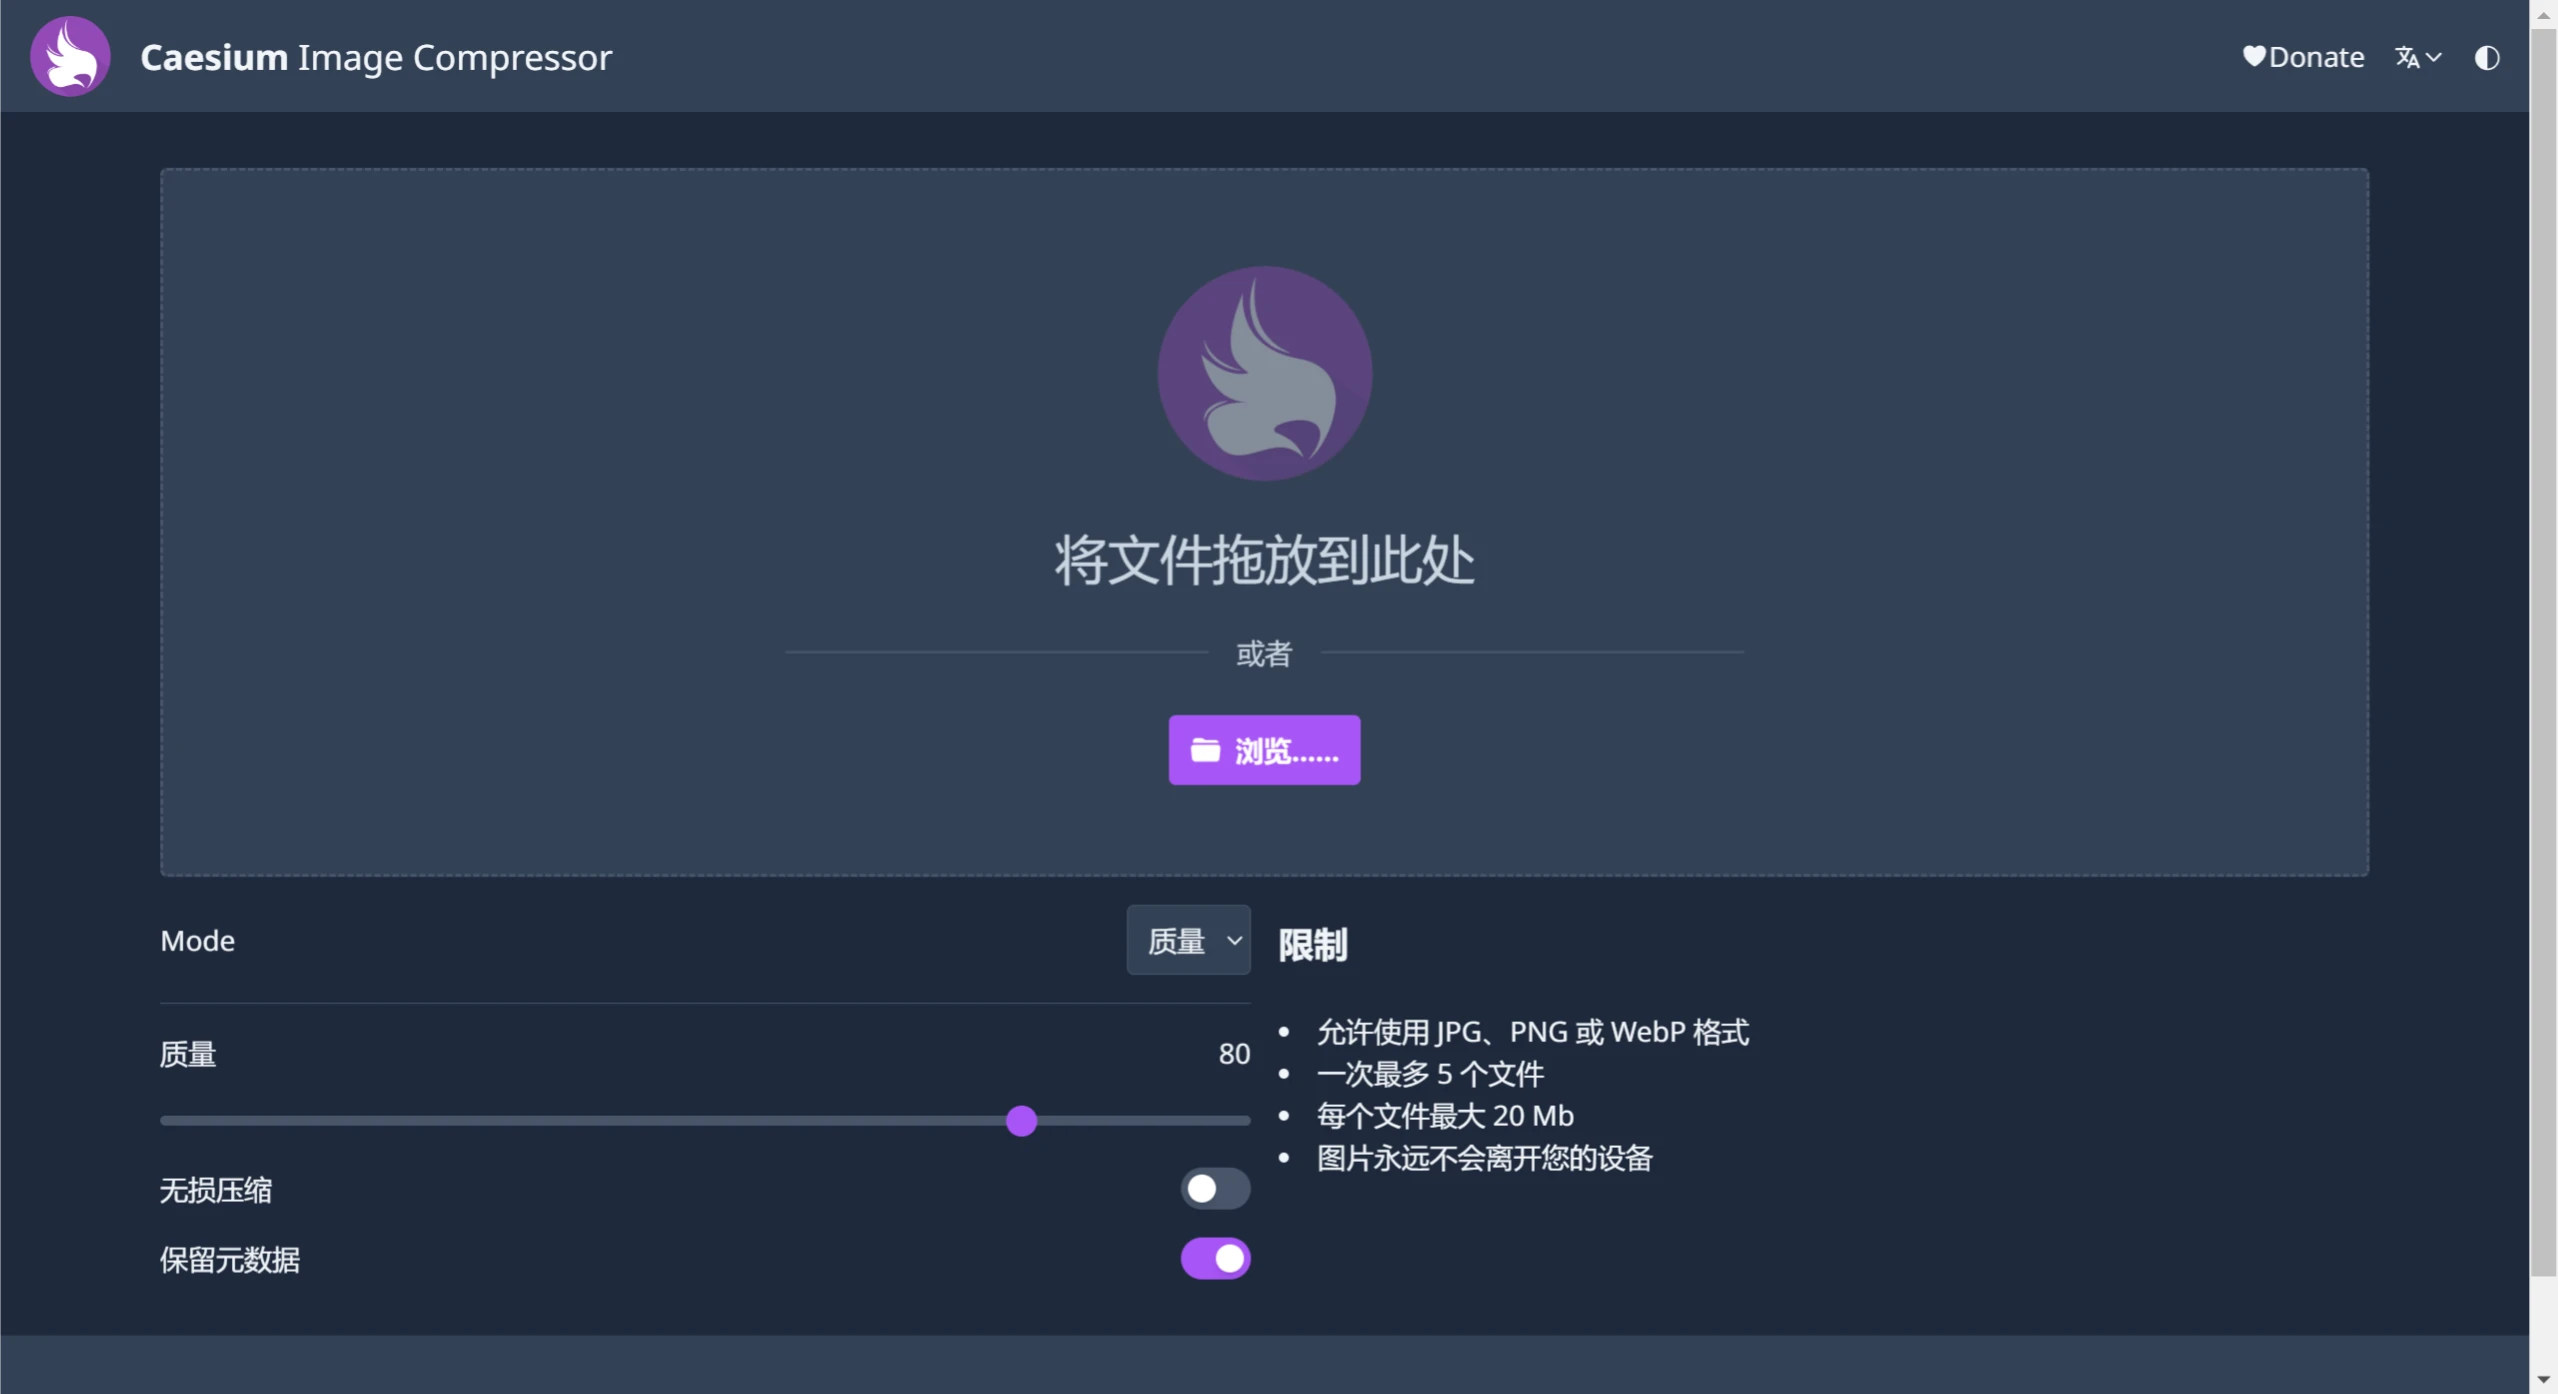
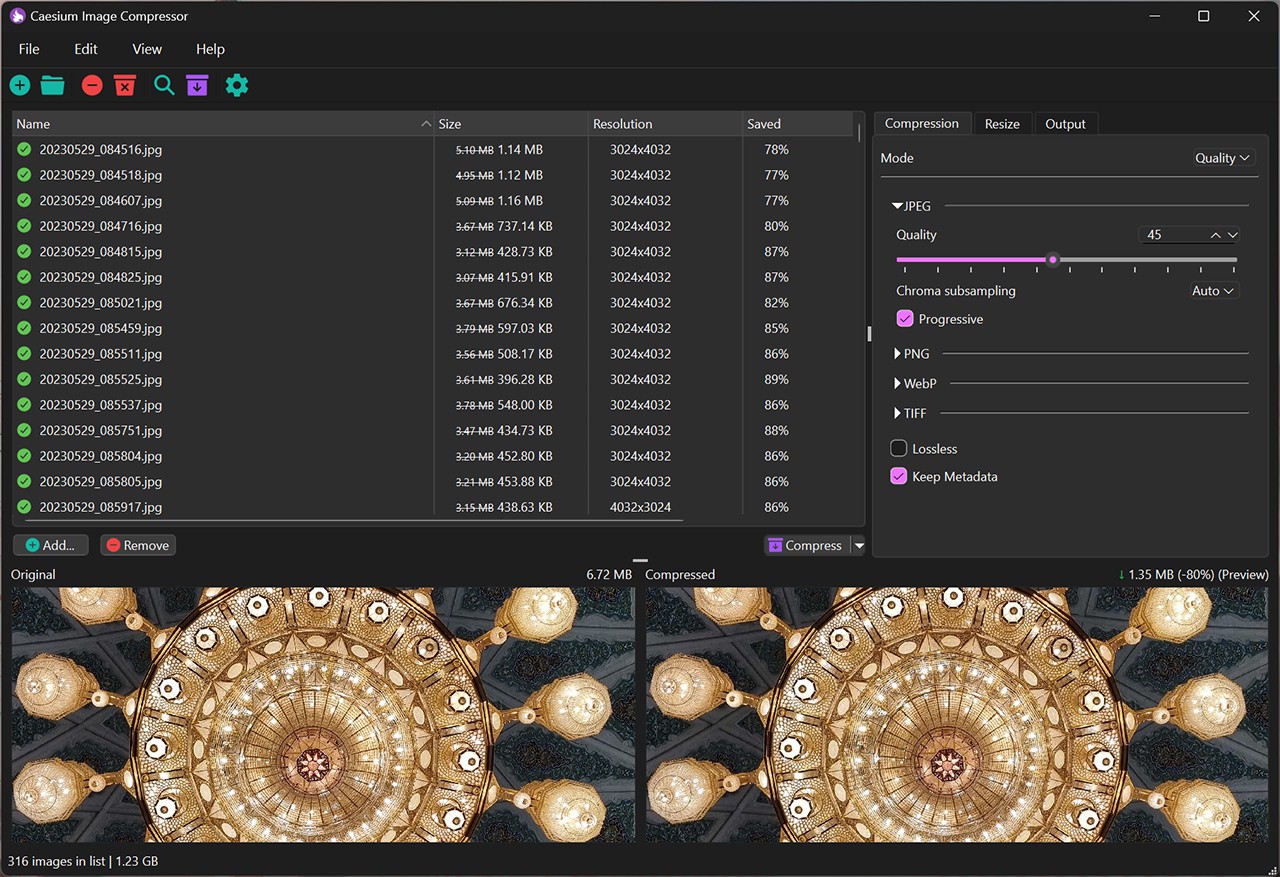
Caesium.app

一款免费的开源在线图像压缩工具,Caesium支持JPG、PNG等格式的批量处理和预览功能。能将照片压缩至原始大小的90%。

Arxiv

一款能够一键将arXiv上的论文转换为Markdown格式的浏览器插件,无论该论文呈现的是摘要、PDF版本还是HTML版本。