图像

Valley

Valley是一款由字节跳动开发的多模态大语言模型,擅长处理文本、图像和视频数据,广泛应用于内容分析、图像和视频描述、电子商务及短视频平台等领域。其Eagle版本通过引入VisionEncoder增强了模型性能,支持灵活调整令牌数量,实现了更高效的多模态数据处理。Valley在多项基准测试中表现出色,尤其在参数规模较小的情况下依然保持优异的成绩。

Skywork R1V

Skywork R1V是昆仑万维推出的首个工业级多模态思维链推理模型,具备强大的视觉链式推理能力,可处理数学问题、科学现象分析、医学影像诊断等复杂任务。其技术基于文本推理能力的多模态迁移与混合式训练方法,在多项基准测试中表现优异。模型开源,适用于教育、医疗、科研、内容审核等多个领域,推动多模态人工智能的发展。

OneStory.Art

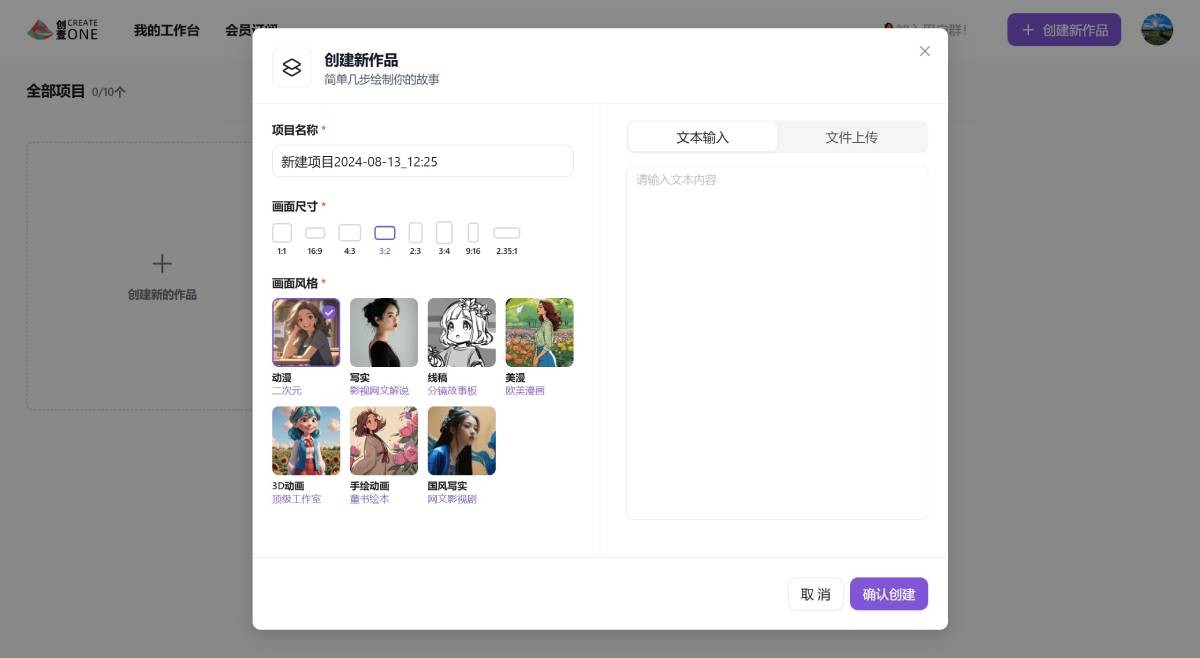
一款创新的AI故事小说网文生成助手,OneStory.Art通过AI快速生成连续性、一致性的角色和故事网文,提供影视分镜、网文图片、游戏漫画以及更多内容创作。

LineArt

LineArt是一种无需训练的高质量设计绘图外观迁移框架,能将复杂外观特征准确转移到设计图纸上,同时保留结构细节。其技术基于模拟人类视觉认知过程,结合艺术经验指导扩散模型,支持工业设计、室内设计、服装设计等多个领域应用。具备高效、高保真和易用性等特点,适用于快速生成逼真效果和优化设计流程。

DemoFusion

DemoFusion是一个技术框架,旨在低成本生成高分辨率图像。该框架通过扩展现有的开源生成人工智能模型(如Stable Diffusion),使得这些模型能够在不进行额外训练和不产生过高内存需求的情况下,将模糊的低分辨率图像转化为高清晰度图像。DemoFusion采用渐进式增强、跳跃残差和扩张采样机制,确保高分辨率图像生成的同时,保持图像的全局语义一致性和细节质量。适用于艺术创作、游戏开发、电影

123RF

123RF是一个图库平台,提供数百万高清免版税的库存照片、向量图、插图和剪贴画,可用于各种商业用途,无需额外许可。

FlexiAct

FlexiAct是由清华大学与腾讯ARC实验室联合研发的动作迁移模型,可在空间结构差异较大的场景下实现精准动作迁移,并保持目标主体的外观一致性。其核心模块包括轻量级RefAdapter和频率感知动作提取(FAE),有效提升跨主体动作迁移的灵活性与准确性。该模型适用于影视、游戏、广告等多个领域,具有良好的应用前景。

SigStyle

SigStyle是一款由多所高校与Adobe合作开发的签名风格迁移框架,能将单张风格图像的视觉特征(如几何结构、色彩和笔触)精准迁移到目标图像,同时保持内容的语义和结构。其核心技术基于个性化文本到图像扩散模型,结合超网络和时间感知注意力交换技术,实现高效且高质量的风格迁移。支持多种应用场景,如艺术创作、时尚设计、影视制作等,具备灵活性和广泛适用性。

TokenVerse

TokenVerse 是一种基于扩散模型的多概念图像生成工具,支持从单图或多图中解耦并组合视觉元素,如物体、材质、姿势等。通过优化调制空间,实现对复杂概念的局部控制,无需微调模型即可生成个性化图像,适用于创意设计、艺术创作和内容生成等多种场景。


ParGo

ParGo是一种由字节与中山大学联合开发的多模态大语言模型连接器,通过结合局部与全局token,提升视觉与语言模态的对齐效果。其核心模块PGP和CPP分别提取图像的局部和全局信息,增强细节感知能力。在多个基准测试中表现优异,尤其在文字识别和图像描述任务中优势明显。采用自监督学习策略,提高模型泛化能力,适用于视觉问答、图像字幕生成、跨模态检索等多种场景。