模型

EMO2

EMO2是一种由阿里巴巴智能计算研究院开发的音频驱动头像视频生成技术,通过音频输入和静态人像照片生成高质量、富有表现力的动态视频。其核心技术包括音频与手部动作的协同建模、扩散模型生成视频帧,以及高精度音频同步。该工具支持多样化动作生成,适用于虚拟现实、动画制作和跨语言内容创作等场景,具备自然流畅的视觉效果和丰富的应用场景。

Speech

Speech-02 是 MiniMax 推出的先进文本到语音模型,支持零样本语音克隆和高质量语音合成,具备多语言支持和情感控制功能。采用自回归 Transformer 和 Flow-VAE 架构提升语音自然度和相似度,适用于配音、有声读物、智能助手等多种场景。提供 HD 和 Turbo 两个版本,满足不同性能需求。

MVGenMaster

MVGenMaster是一款基于多视图扩散模型的工具,利用增强的3D先验技术实现新视角合成任务。它可以从单一图像生成多达100个新视图,具有高度的灵活性和泛化能力。模型结合了度量深度、相机姿态扭曲以及全注意力机制等技术,支持高效的前向传播过程,同时兼容大规模数据集。MVGenMaster在视频游戏、电影特效、虚拟现实、3D建模及建筑可视化等领域具有广泛应用前景。
ViVa AI

Sora同架构视频生成模型,支持文本生成视频、图片生成视频以及 4K 分辨率放大功能,另外也支持提示词的自动优化。

OLMoE

OLMoE是一款基于混合专家(MoE)架构的开源大型语言模型,具有高效的稀疏激活机制和快速训练能力。它支持自然语言理解、文本生成、多任务处理等功能,并广泛应用于聊天机器人、内容创作、情感分析和问答系统等领域,通过预训练和微调实现高精度任务执行。 ---

smoltalk

Smoltalk-Chinese 是 OpenCSG 开发的中文大型语言模型专用合成数据集,包含 70 多万条高质量数据,涵盖多种任务类型,如信息查询、编程、数学、创意写作等。数据通过先进模型生成并经过严格筛选和去重,确保多样性与质量,适用于模型微调和多场景应用,提升语言理解和生成能力。

Audio2Photoreal

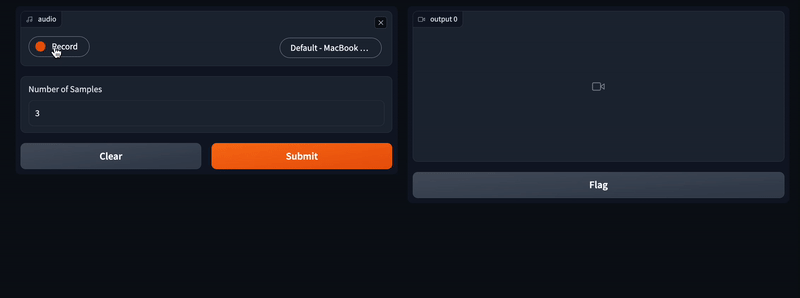
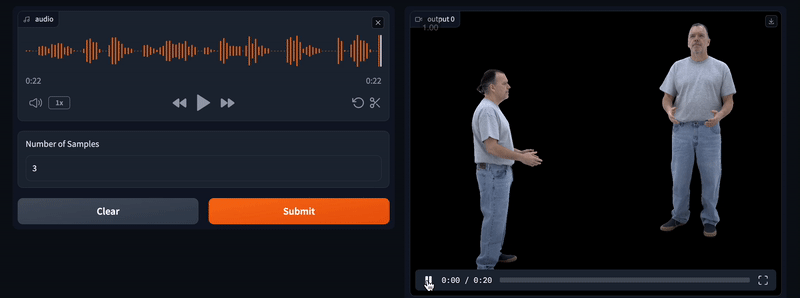
从音频生成全身逼真的虚拟人物形象。它可以从多人对话中语音中生成与对话相对应的逼真面部表情、完整身体和手势动作。

汉王天地大模型

汉王天地大模型是一个综合性的AI语言助手,它通过提供丰富的语言处理功能,帮助用户在多种场景下提高效率和创造力。

FlowiseAI

FlowiseAI 是一款开源的低代码 AI 工具,允许用户通过可视化拖拽方式快速构建大型语言模型应用。支持多模型集成、对话记忆、API 接口等功能,适用于聊天机器人、工作流自动化和文档问答等多种场景。提供本地、Docker 和云平台部署方式,适合开发者和企业用户进行灵活应用开发。

魔多AI

一个专为AI创作者打造的趣玩社区,提供多种AI模型和创作工具,支持用户进行插画、动漫、写实等多种风格的图像创作。