多模态

SwiftChat

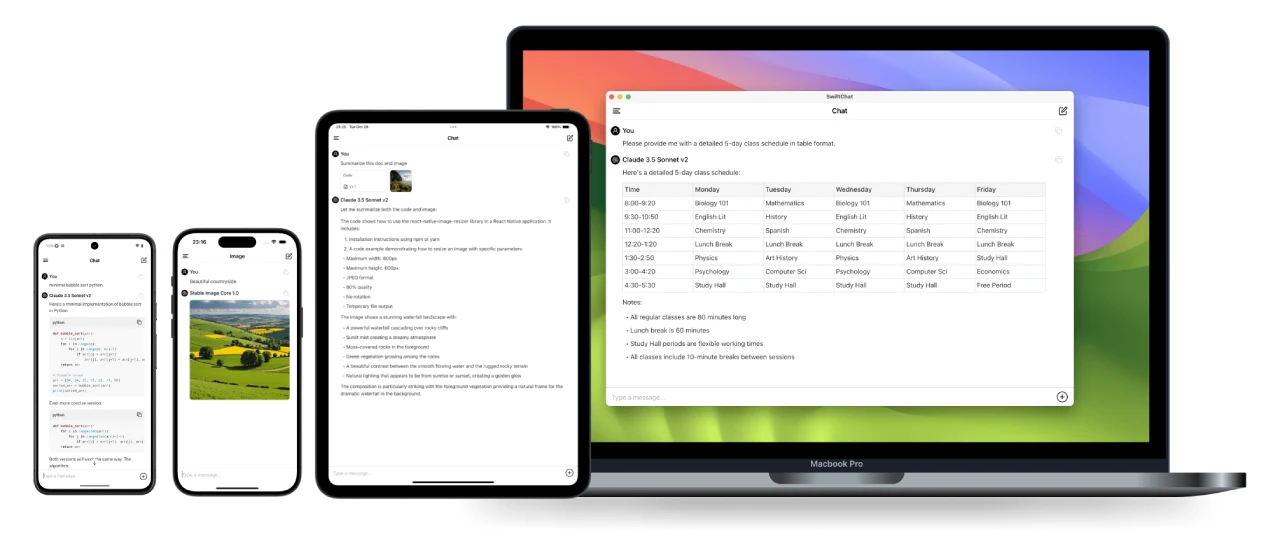
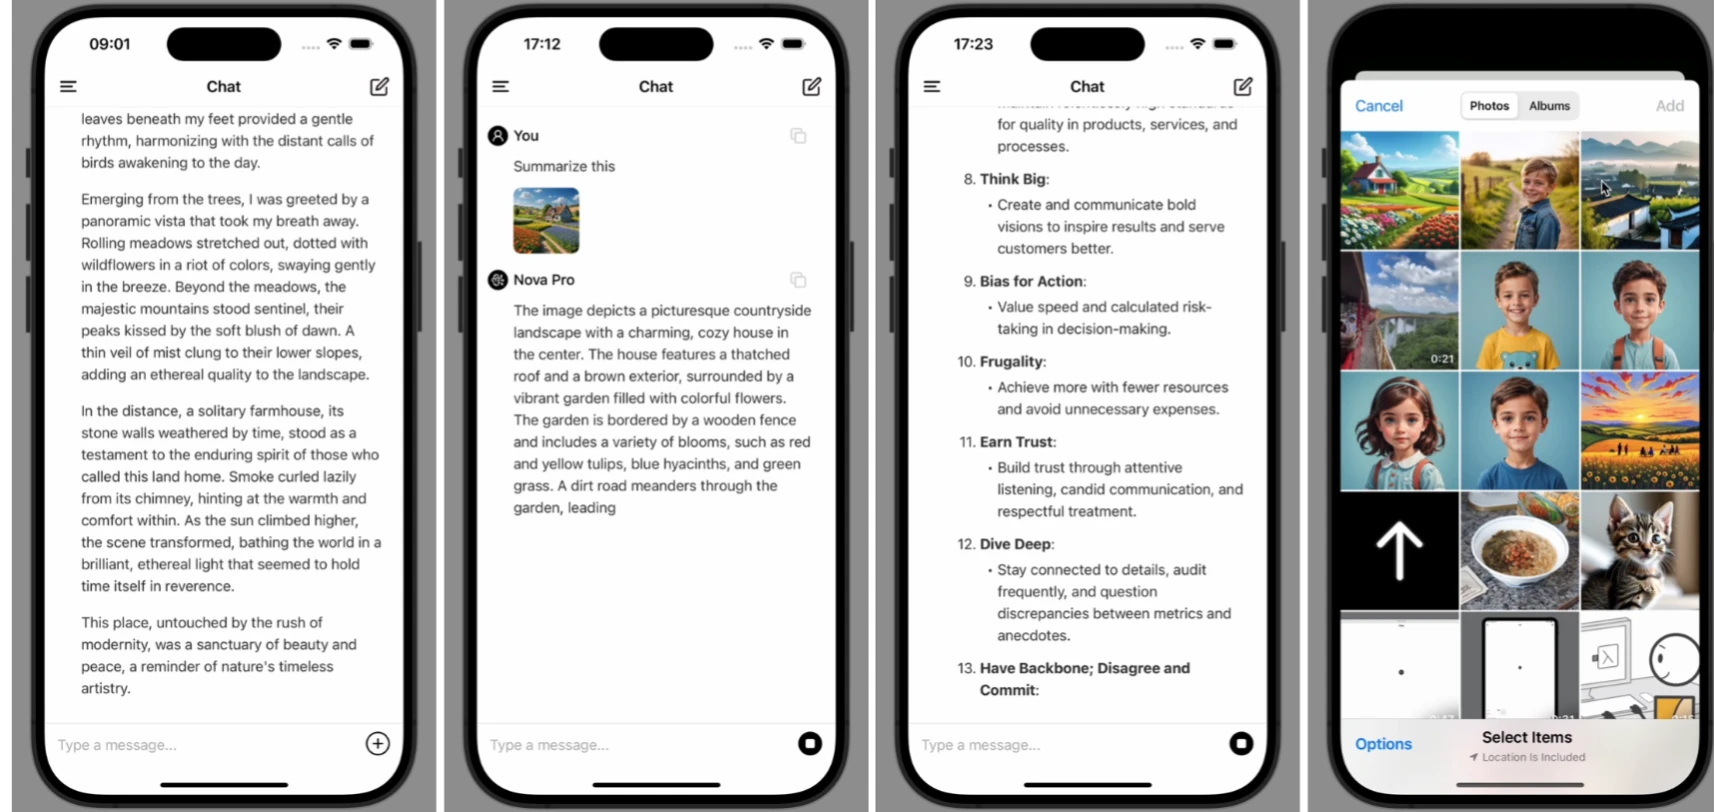
一款基于React Native开发的快速、安全、跨平台聊天应用,支持实时流式聊天功能和Markdown语法,还可以生成AI图像,兼容DeepSeek、Amazon Bedrock、Ollama和OpenAI等模型。

狸谱

狸谱是一款集AI图像处理与互动创作于一体的多功能工具,提供“灵魂提取器”功能用于生成物体相关人设形象,同时拥有AI壁纸漫画创作、跑团剧情互动及自定义画风等功能。狸谱凭借其多模态大模型技术和丰富的应用场景,满足用户在娱乐、创意、教育等多个领域的多样化需求。

LangGraph WhatsApp Agent

LangGraph WhatsApp Agent 是一个开源 AI 工具,用于在 WhatsApp 上构建智能代理。支持多代理架构、多模态交互及持久化对话状态,集成多种语言模型,提供安全可靠的通信环境。适用于客户服务、信息推送、教育辅导等多个场景,便于开发者快速构建和部署高效的 WhatsApp 机器人。

Fluig

Fluig 是一款基于 AI 的图表生成工具,可将文字、文档或代码快速转化为多种专业图表,如思维导图、流程图等。支持多模态输入和智能格式转换,操作简便,适合无设计背景的用户使用。提供实时协作功能,适用于教育、商业、研究等多个场景,提升信息可视化与团队协作效率。

Gemma 3 QAT

Gemma 3 QAT 是谷歌推出的开源 AI 模型,采用量化感知训练技术,在降低显存需求的同时保持高性能。它支持多模态任务,具备 128,000-token 长上下文处理能力,并可在消费级 GPU 和边缘设备上运行。适用于视觉问答、文档分析、长文本生成等场景,同时兼容多种推理框架,便于部署。

OpenVision

OpenVision是加州大学圣克鲁兹分校推出的多模态视觉编码器系列,具备从5.9M到632.1M参数的多种模型,适用于不同硬件环境。其采用渐进式多阶段分辨率训练策略,训练效率比同类模型高2至3倍,在多模态任务中表现优异。支持可变大小patch输入,兼具灵活性与高效性,广泛应用于工业检测、机器人视觉、自动驾驶及科研教育等领域。

Aria

Aria是首个开源多模态原生混合专家(MoE)模型,支持文本、代码、图像和视频的综合处理,具有强大的多模态任务处理能力和长上下文窗口,可高效应对复杂长数据。模型开源且可扩展,适用于多模态AI领域的研究与应用。

Steamer

Steamer-I2V 是百度 Steamer 团队推出的图像到视频生成模型,能够将静态图像转化为动态视频,具备卓越的视觉生成能力。该模型基于 Transformer 扩散架构,支持多模态输入,包括中文文本提示和参考图像,实现像素级的画面控制与电影级构图效果。在 VBench 评测中荣获榜首,生成高清 1080P 视频,优化时间一致性与运动规律性,适用于广告、影视、游戏开发和内容创作等多个领域。

Awesome Chinese LLM

整理了开源的中文大语言模型(LLM),主要关注规模较小、可私有化部署且训练成本较低的模型,目前已收录了100多个相关资源。

Vidu 1.5

Vidu 1.5是一款基于多模态视频大模型的AI生成工具,支持参考生视频、图生视频和文生视频生成,通过精准的语义理解能力,在30秒内完成高质量视频创作,适用于影视、动漫、广告等多行业场景,助力创作者高效产出多样化内容。